Disponible pour une alternance de 12 à 24 mois
Pierre Steve NGWEHA PENI
Étudiant en Data Science
Étudiant en Data / AI Engineering, je passe mon temps à transformer de la donnée brute en outils concrets. Qu'il s'agisse d'automatiser des pipelines SQL, de concevoir des Dashboard Power BI ou de coder des agents IA, j'adore construire des solutions de bout en bout. Mon obsession ? Ne pas faire compliqué pour le plaisir de faire compliqué. Je pars toujours du besoin métier pour livrer l'outil le plus simple, robuste et utile pour ceux qui vont l'utiliser.
Focus
Data & IA
Réalisation
+7 projets
500K+
références produits traitées via PySpark
29K+
messages analysés et visualisés dans CrewMind
-100 ms
de latence d'inférence image sur MasktrackerIA
87%
de précision Top-5 sur l'architecture RAG
99,9%
d'uptime cible sur le cluster Kubernetes
-80%
de temps de sourcing sur le pipeline Smart Buy Sentinel
Expériences
Stagiaire Développeur Web
Digital Business SARL
Développement d'un site e-commerce full-stack (catalogue, panier, paiement) en collaboration avec un mentor, générant +40% de commandes en ligne vs vente physique dès le premier mois post-lancement. Participation à la conception du modèle de données du site (catalogue produits, commandes, paiements), garantissant la cohérence et l'intégrité des transactions. Maintenance du parc informatique et support technique utilisateurs sur plus de 20 postes.
Stagiaire Développeur Web
Helite High Tech
Conception et administration de bases de données MySQL pour plusieurs sites clients (modélisation des tables, relations, contraintes d'intégrité). Optimisation des requêtes SQL (indexation, réécriture de requêtes), réduction du temps de chargement de 35%. Structuration et extraction de données pour l'intégration front-end en responsive design.
Compétences
Data & IA
Langages
Bases de données
DevOps / Cloud
Visualisation
Frameworks Web
Formation
Master of Science — Ingénierie Data
SUPINFO Paris
Big Data, Data Engineering, Cloud, MLOps, Architecture SI
Master orienté ingénierie de la donnée à grande échelle : Big Data, Data Engineering, Cloud, MLOps et Architecture SI.
Bachelor Développeur Data & IA
ECE Paris
Machine Learning, Deep Learning, Python, SQL, DevOps
Formation en développement orienté données et intelligence artificielle : Machine Learning, Deep Learning, Python, SQL, DevOps.
Licence Génie Informatique — Génie Logiciel
ESATAG, Yaoundé
Conception logicielle, UML, POO, Bases de données, Agile
Licence en génie logiciel : conception logicielle, UML, programmation orientée objet, bases de données, méthodes Agile.
BTS Génie Informatique — Génie Logiciel
IUM, Yaoundé
Algorithmique, Programmation, Bases de données, Réseaux, OS
BTS en génie logiciel : algorithmique, programmation, bases de données, réseaux informatiques, systèmes d'exploitation.
Projets
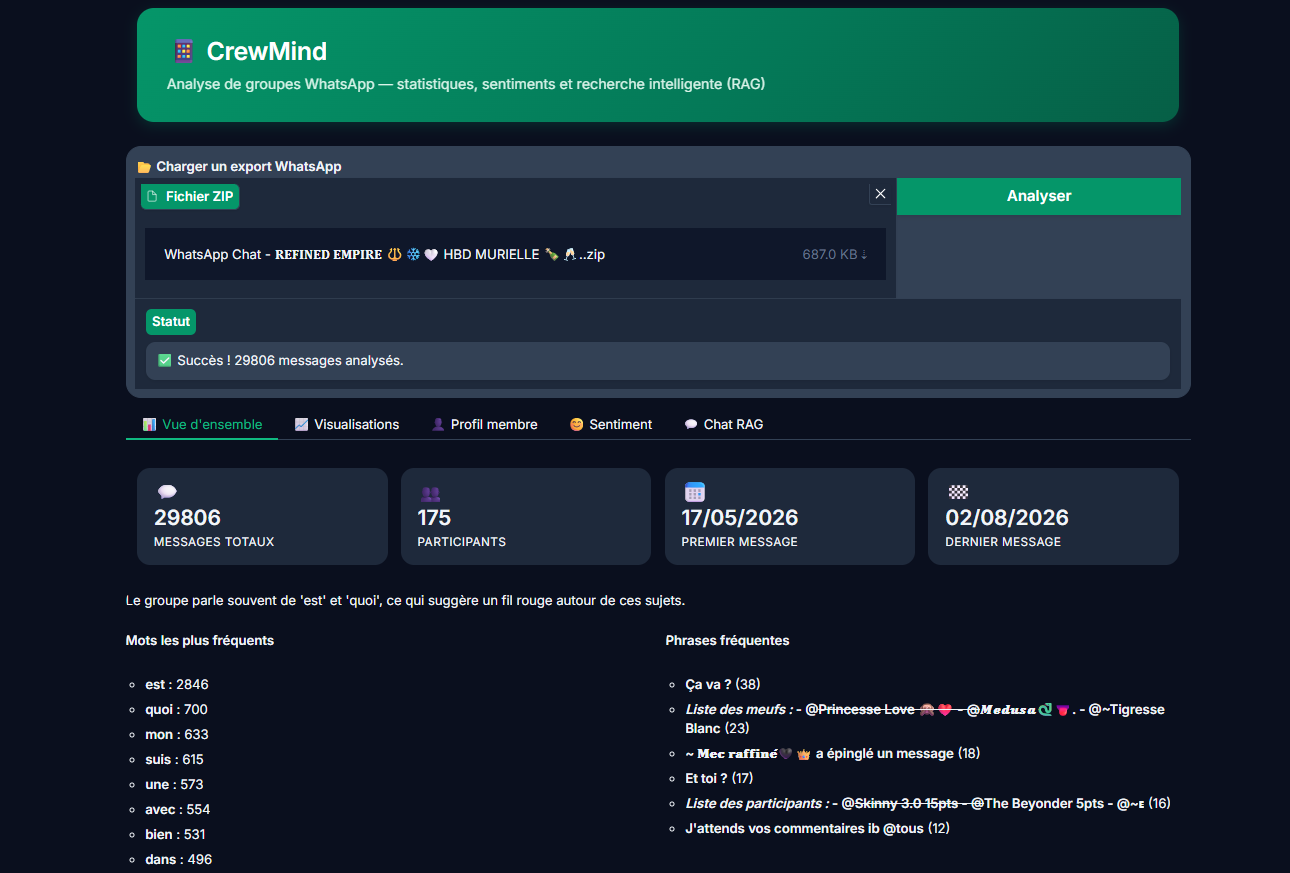
CrewMind — Analyse WhatsApp par IA
Analyse d'export WhatsApp avec profils membres, sentiment et chatbot RAG.
Application Streamlit qui charge un export WhatsApp (archive ZIP), parse les messages en DataFrame structuré, et propose une analyse complète du groupe. NLP appliqué à deux niveaux : profils membres (mot préféré, sentiment dominant par participant, heure de pointe d'activité) et humeur globale du groupe via analyse de sentiment sur échantillon, avec résultats en graphique et tableau. Visualisations poussées : volume de messages par expéditeur, activité temporelle, heatmap horaire, nuage de mots. Un chatbot RAG permet d'interroger l'historique du groupe en langage naturel : il recherche les messages les plus similaires à la question via ChromaDB et sentence-transformers, puis affiche les extraits pertinents avec leurs sources. Traite de gros volumes sans ralentir : plus de 29 000 messages traités sur un export réel, grâce à un parsing par pattern compilé et une indexation ChromaDB effectuée une seule fois par fichier (cache local), avec état de session Streamlit pour éviter les rechargements entre onglets. Conteneurisé via Docker Compose avec volumes persistants pour les données et l'index vectoriel. Consentement RGPD affiché au démarrage.
29 000+ messages analysés · NLP par membre + humeur du groupe · recherche RAG quasi instantanée grâce au cache d'indexation
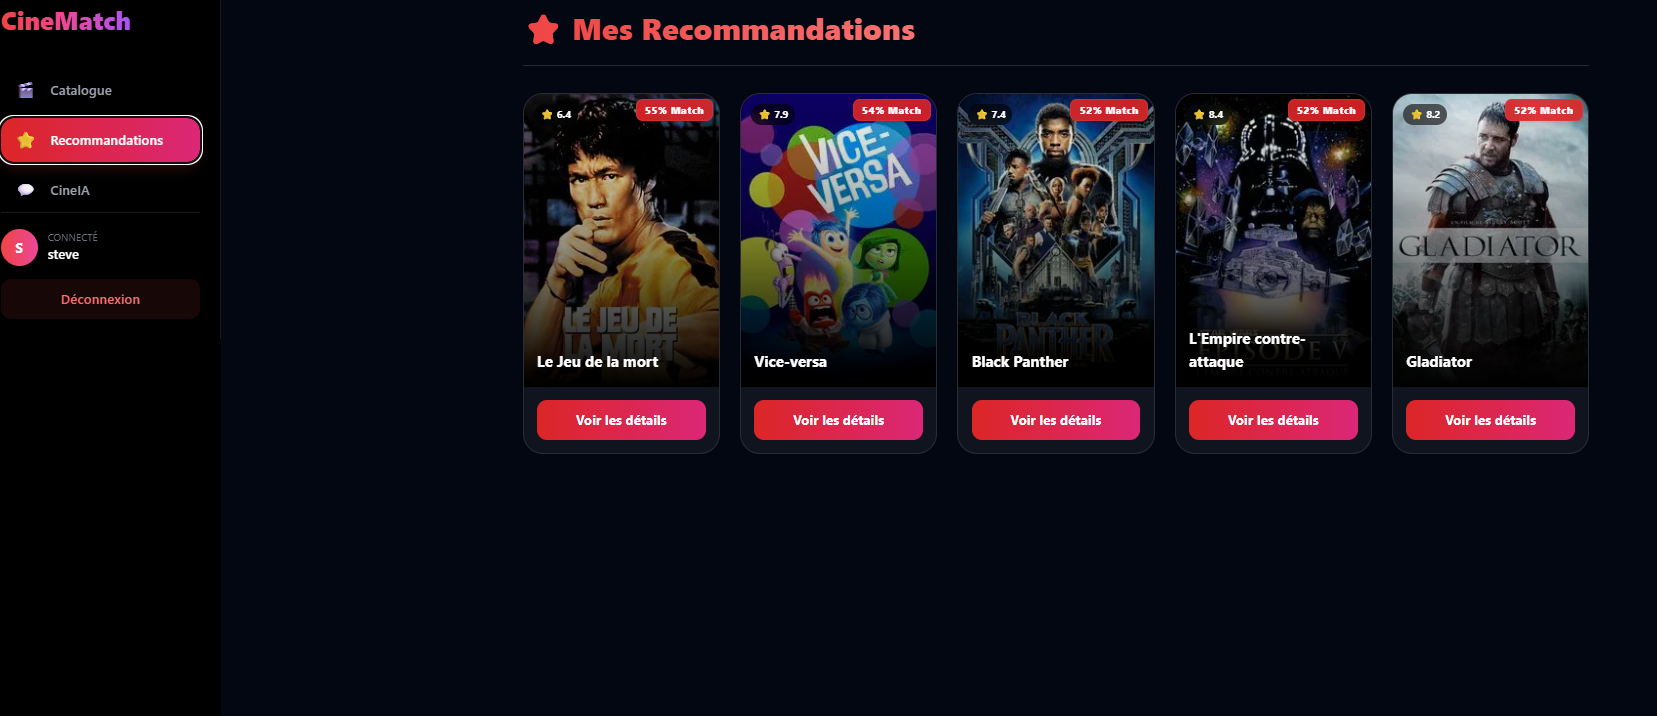
RAG CineMatch
Système de recommandation de films par LLM & RAG.
Problème résolu : les recommandations de films génériques ne prenaient pas en compte les préférences sémantiques de l'utilisateur. Architecture RAG : ingestion de plus de 5000 synopsis via l'API TMDB, embeddings HuggingFace (sentence-transformers), indexation dans FAISS, génération via Mistral/Ollama orchestrée par LangChain. Pipeline ETL : scraping et nettoyage automatisé en Python et Pandas, mise à jour incrémentale du vector store. Résultats : précision Top-5 de 87% (MRR@5), latence de réponse inférieure à 1,2 seconde, déployé via Docker Compose.
Précision Top-5 de 87% (MRR@5) · latence < 1,2 s
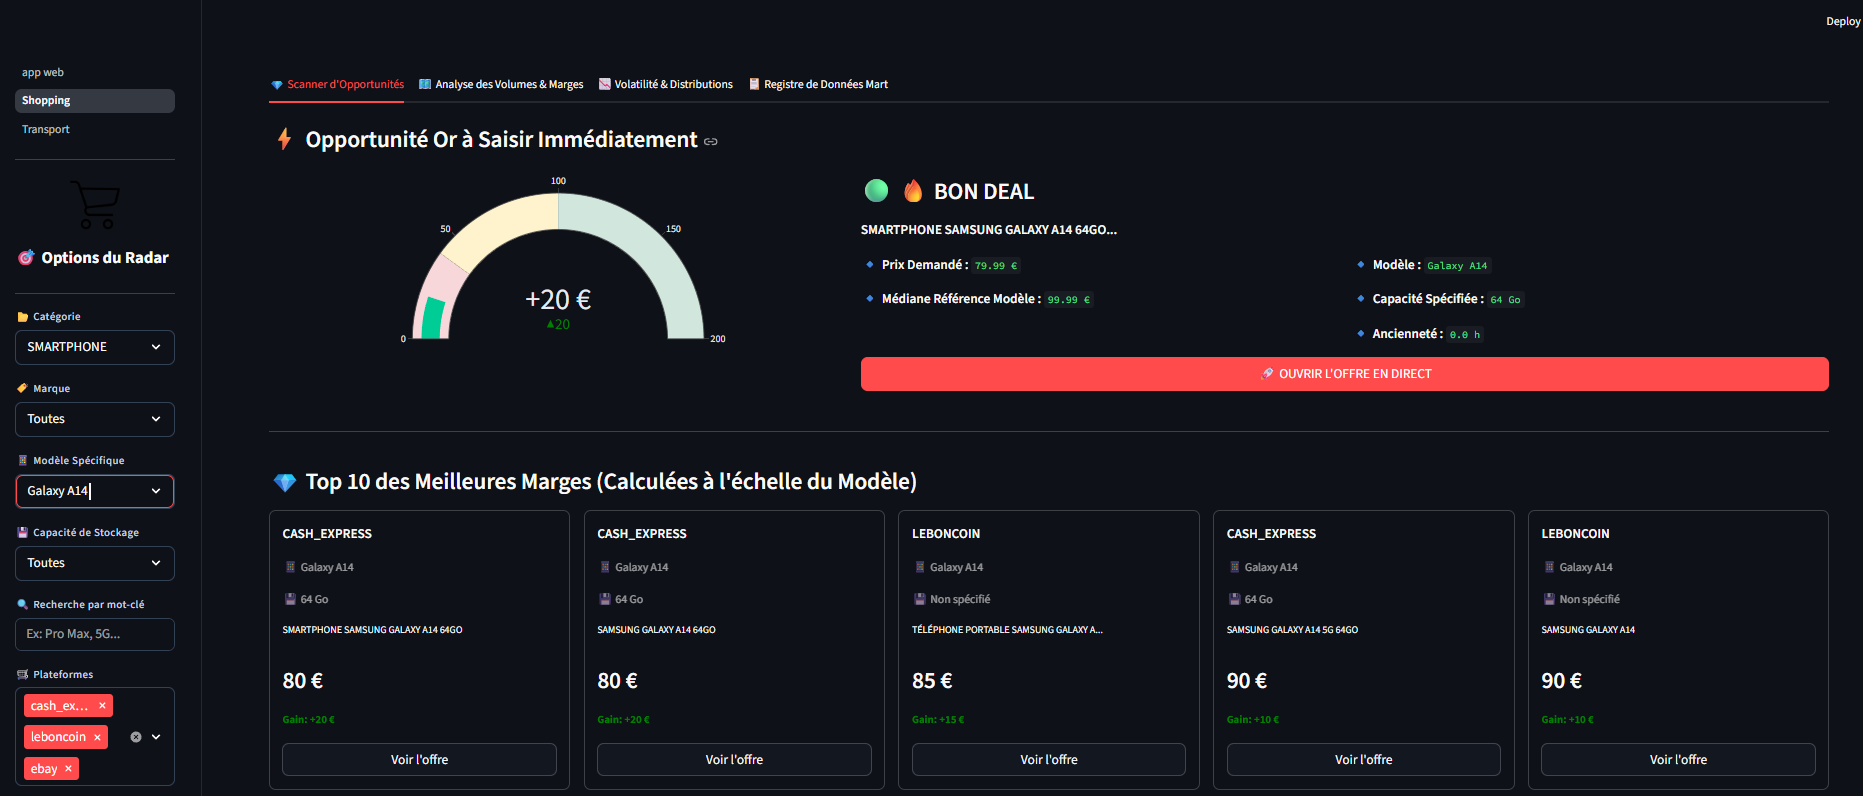
Pipeline Data — Optimisation de Marché
Pipeline ETL Big Data avec PySpark, Airflow et dbt.
Problème résolu : élimination de la recherche manuelle et subjective d'articles sur le marché. Architecture ETL complète avec Airflow pour l'orchestration et PySpark pour le traitement massif, sur plus de 500 000 références produits. Data modeling : normalisation via dbt en 5 couches (Bronze à Gold), et algorithme de Deal Scoring basé sur le Z-Score pour automatiser la détection d'opportunités à forte marge. Stack : MongoDB, Streamlit pour le dashboard, bot Telegram pour l'alerting en temps réel.
−80% du temps de sourcing produit vs recherche manuelle
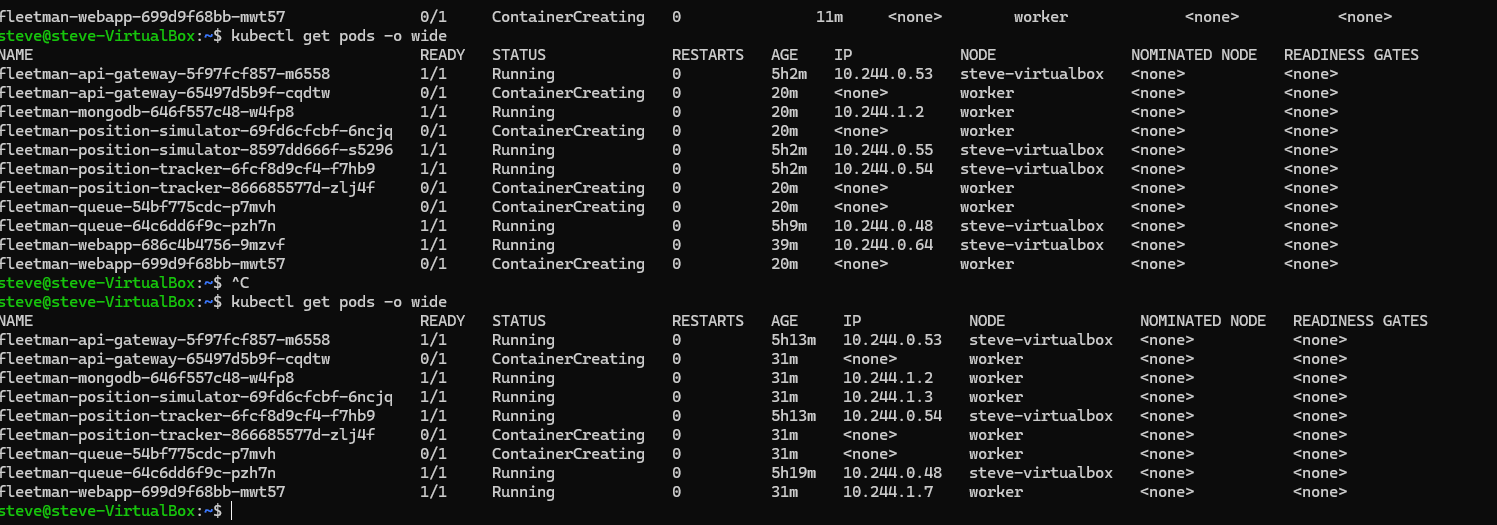
Orchestration Microservices Temps Réel — Fleetman
Migration d'une architecture microservices vers Kubernetes.
Infrastructure : déploiement d'un cluster multinœud, un master et deux workers, sur VM Ubuntu via Kubeadm et Containerd. Migration Kubernetes : migration d'une architecture microservices basée sur Spring Boot et ActiveMQ, de Docker Compose vers Kubernetes, avec gestion des manifests, services et ingress. Storage et résilience : persistance MongoDB avec PV/PVC, configuration haute disponibilité, cible d'uptime de 99,9%.
Cible uptime 99,9%
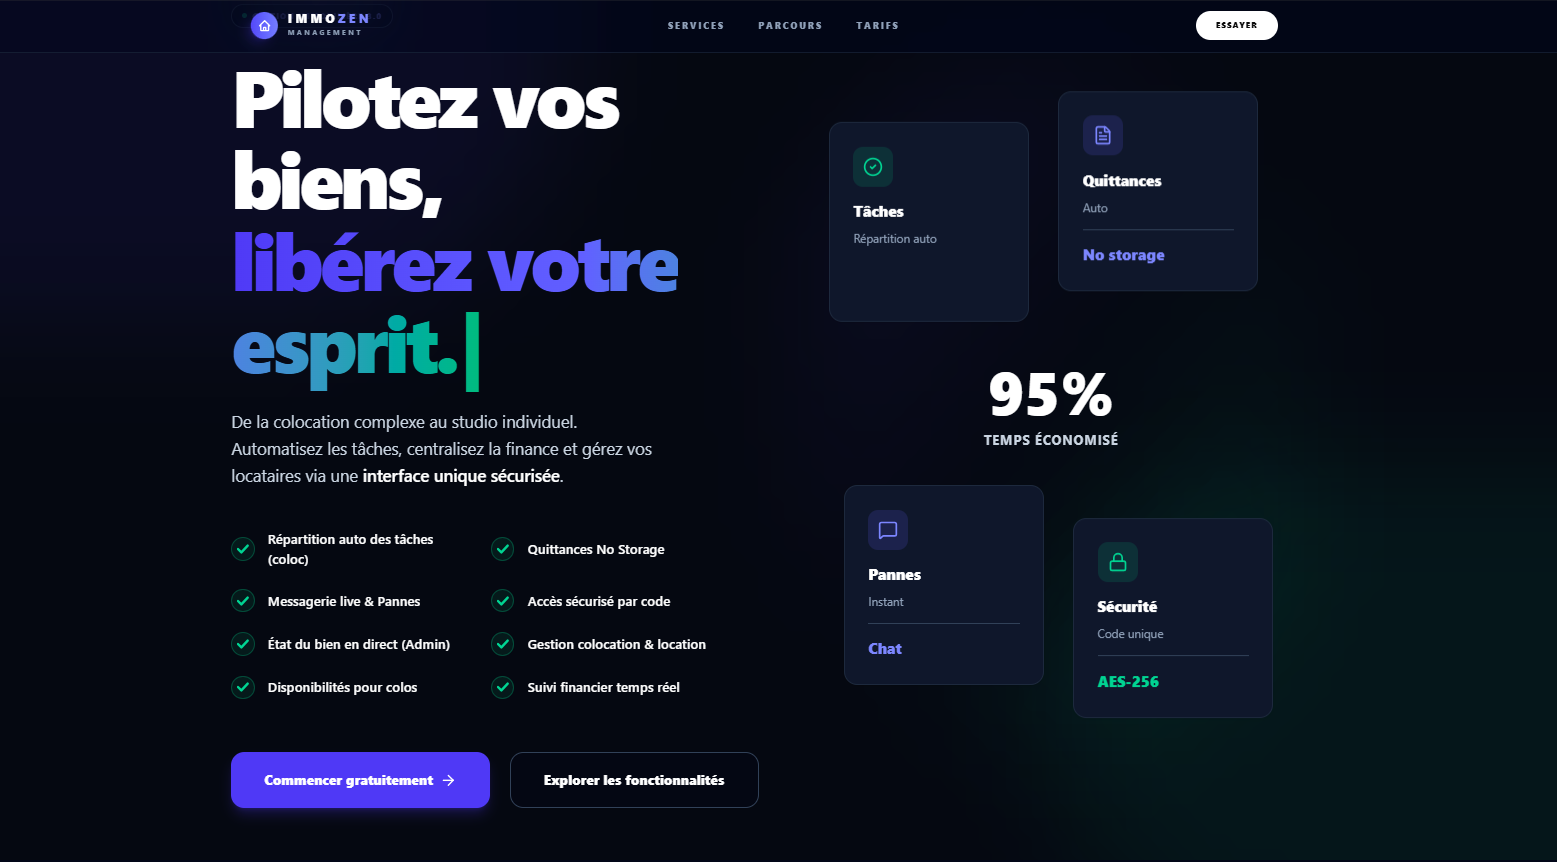
immozen.space
SaaS de gestion locative en Next.js, Node.js et MongoDB.
Problème résolu : automatisation de la maintenance en colocation via un algorithme d'attribution de tâches. Fonctionnalités : validation par traitement d'image via Cloudinary, signalement d'incidents, notifications par courriel, dashboard propriétaire, quittances automatiques. Stack technique : Next.js pour la vitrine et les leads, React Expo pour la PWA mobile, Node.js pour le backend, MongoDB.
−60% d'interventions non planifiées · 3 colocations pilotes
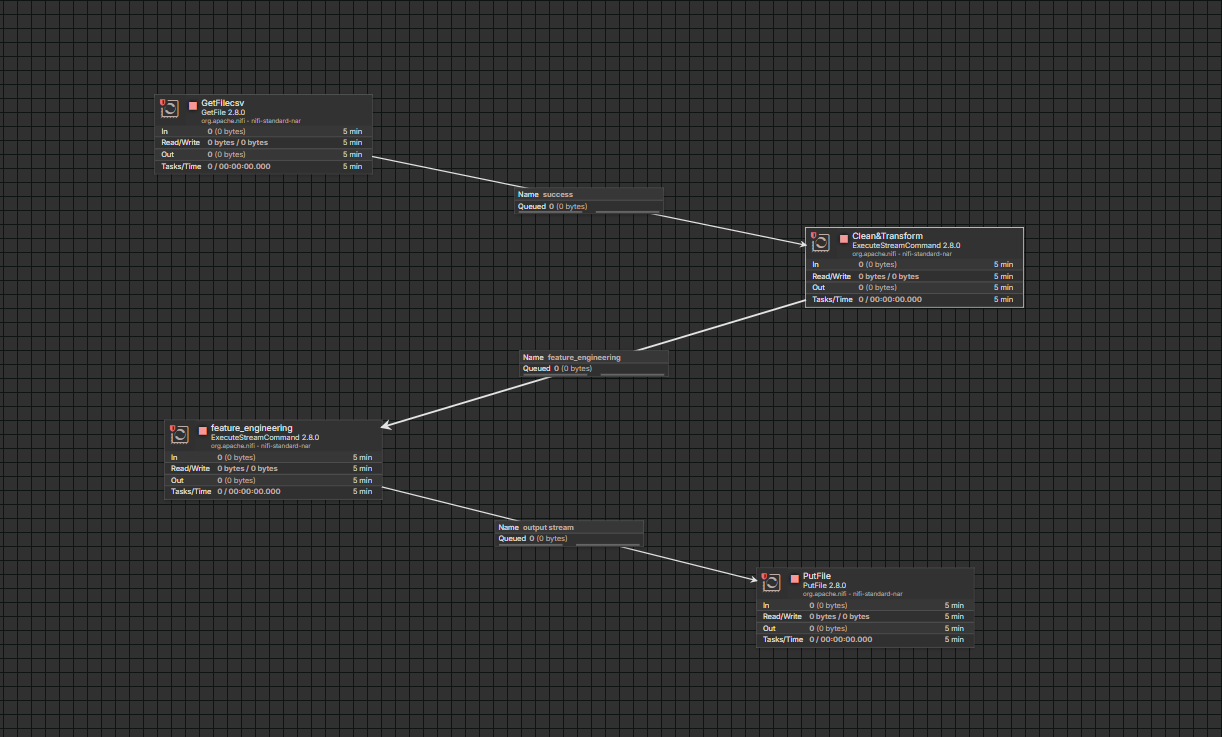
Pipeline ETL & Visualisation E-commerce
Flux ETL RGPD-compliant avec dashboard décisionnel PowerBI.
Flux automatisé en Python et NiFi pour le traitement de données transactionnelles sensibles. Anonymisation RGPD sur plus de 17 champs, nettoyage et enrichissement de données transactionnelles. Dashboard PowerBI décisionnel pour l'analyse des comportements d'achat sur plus de 100 000 transactions, avec adoption par l'équipe métier dès le septième jour.
Adoption équipe métier dès J+7 sur 100 000+ transactions
AI. MILO
Détection temps réel du port du masque par computer vision.
Problème résolu : le contrôle manuel du respect du port du masque dans les lieux à forte affluence n'était pas systématique. Architecture : modèle YOLOv8 exporté en ONNX Runtime, exposé via une API FastAPI. Pipeline OpenCV et ffmpeg pour l'annotation vidéo en encodage H.264. Détection en direct dans le navigateur via webcam avec overlay en temps réel. Optimisation vitesse : sous-échantillonnage adaptatif des frames vidéo et inférence déportée sur threadpool, traitement vidéo jusqu'à 4 fois plus rapide, inférence image en moins de 100 millisecondes. Déploiement : conteneurisation Docker, mise en production sur Hugging Face Spaces.
Traitement vidéo 4x plus rapide · inférence < 100 ms